Un sondage d’intentions de vote fondé sur une liste demande aux répondants de choisir parmi des personnalités précises. Le résultat décrit les préférences exprimées dans cette configuration, à un moment donné. Ajouter ou retirer un nom modifie les options offertes : avant de rapprocher deux pourcentages, il faut donc examiner la composition des listes, ainsi que les dates et la méthode des enquêtes.
Prenons un exemple
David Lisnard ne figure dans aucune des trois hypothèses de premier tour du sondage OpinionWay pour le JDD, réalisé les 2 et 3 septembre 2026. Une semaine plus tard, les 9 et 10 septembre, son nom apparaît dans les trois configurations du sondage OpinionWay pour CNews. Les deux notices donnent accès aux questionnaires : OpinionWay pour le JDD, pages 5–6, OpinionWay pour CNews, pages 5–6.
Regardons plus précisément l’hypothèse numérotée 3 dans chaque document. Celle du JDD propose dix personnalités. Celle de CNews reprend ces dix noms et en ajoute trois : David Lisnard, Karim Bouamrane et Nicolas Dupont-Aignan. Le choix proposé passe donc de dix à treize personnalités. Lisnard illustre ici une modification du questionnaire qui concerne plusieurs personnes simultanément.
Cette précision change la lecture des résultats. Si le score d’une personnalité présente dans les deux listes change, la comparaison seule n’indique pas pourquoi. L’entrée de Lisnard s’accompagne de deux autres ajouts, les dates de terrain diffèrent et les échantillons ne sont pas identiques. Les notices décrivent ces configurations ; elles n’isolent pas l’effet de chaque changement.
Une différence à décrire avant de l’interpréter
L’absence d’un nom ne suffit pas à juger de la qualité d’une enquête. Les sondages explorent différentes hypothèses de candidature : leur intérêt dépend aussi de la question que l’étude cherche à examiner. Pour apprécier la sélection, il faut connaître son objectif et les critères retenus, plutôt que supposer qu’une liste plus longue serait nécessairement meilleure.
Dans cet exemple, les documents consultés établissent la différence entre les listes. Ils n’expliquent pas l’arbitrage ayant conduit à leur composition. Les motifs restent à documenter auprès de l’institut et des commanditaires. Rien dans cette seule comparaison ne démontre que Lisnard aurait dû figurer dans la première enquête, ni qu’il aurait été favorisé dans la seconde.
L’IA pour comparer les questionnaires
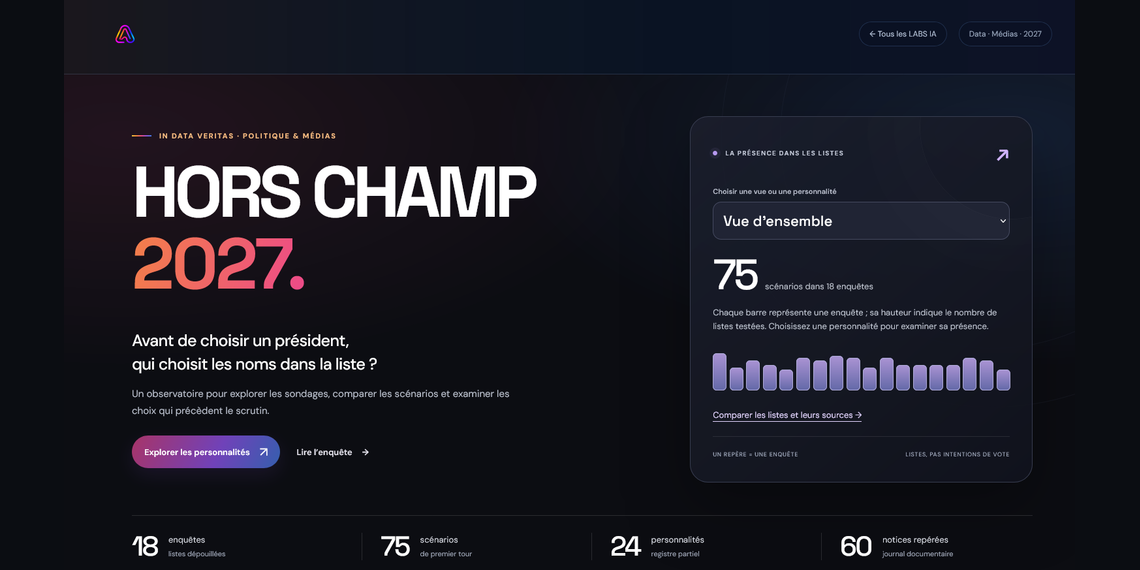
Cette lecture guide Hors champ 2027, le Lab d’IN DATA VERITAS. Sa base exploratoire, arrêtée au 15 septembre 2026, rassemble 18 enquêtes et 75 scénarios de premier tour. Un scénario correspond à une liste testée ; une même enquête en contient parfois plusieurs.
L’IA a assisté le dépouillement des notices et le développement du comparateur. Les listes sont structurées, puis des scripts identifient les noms communs, ajoutés et retirés. Dans l’exemple précédent, le résultat est explicite : dix noms conservés, trois ajouts, aucun retrait. Chaque comparaison renvoie aux documents sources pour vérifier le relevé.
L’outil organise ainsi des informations dispersées dans des PDF. Il ne détermine pas à la place des instituts les personnalités à tester et ne déduit aucun transfert de voix. La base demeure non exhaustive et sa seconde lecture humaine reste à mener.
Pour les rédactions, l’enjeu dépasse cet exemple : signaler les changements de configuration lorsqu’elles commentent les résultats. Une hausse ou une baisse se lit aussi au regard des concurrents proposés aux répondants. La liste fait partie de l’information, au même titre que le score.
Antoine GARCIA