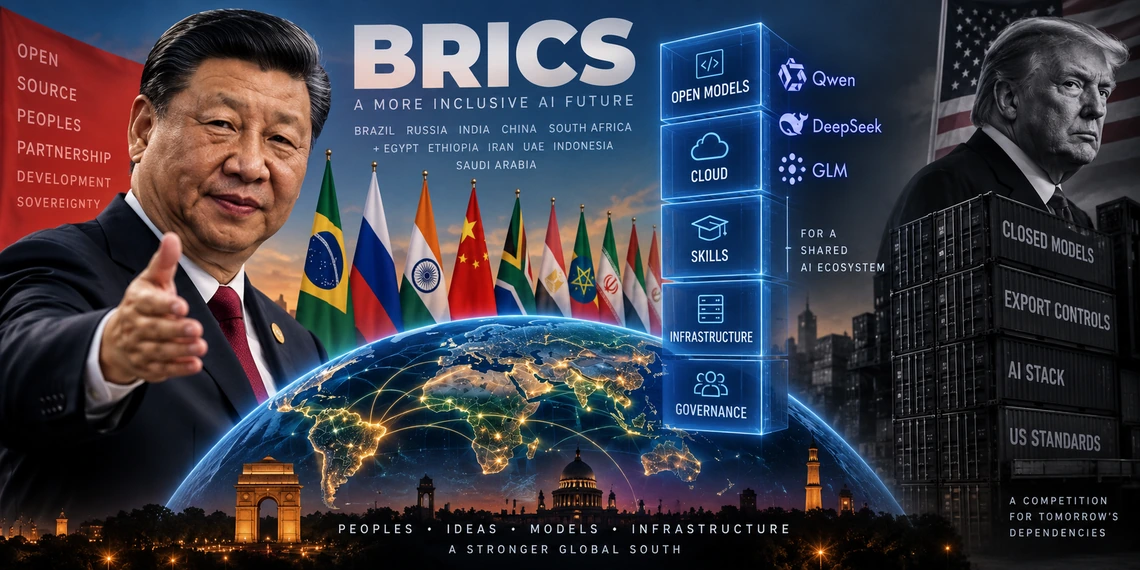
Le calendrier mérite qu’on s’y attarde. Le 8 septembre 2026, Washington accusait six entreprises chinoises, parmi lesquelles DeepSeek, Moonshot AI et Alibaba, d’avoir utilisé à grande échelle la distillation pour reproduire certaines capacités de modèles américains. Pékin rejetait les accusations, dénonçant une tentative supplémentaire de freiner ses entreprises technologiques. Cinq jours plus tard, depuis le sommet des BRICS à New Delhi, Xi Jinping proposait une réponse d’une tout autre nature : la Chine prendrait l’initiative de constituer une communauté d’intelligence artificielle open source entre les membres du groupe.
La proximité des deux événements est fortuite, mais elle raconte assez bien la nouvelle phase de la rivalité sino-américaine. Depuis l’arrivée de ChatGPT, cette compétition s’est essentiellement mesurée à la puissance des puces, aux capacités de calcul, aux milliards investis et aux performances respectives de GPT, Gemini, Claude, Qwen ou DeepSeek. À mesure que les écarts technologiques se réduisent, un autre rapport de force apparaît derrière les benchmarks : savoir non plus seulement qui construira la meilleure intelligence artificielle, mais sur quelles technologies le reste du monde construira la sienne.
Et sur ce terrain, la Chine avance une proposition particulièrement adaptée aux économies qui n’auront ni OpenAI, ni Google DeepMind, ni des centaines de milliers de GPU à leur disposition.
Une proposition chinoise avant d’être une politique des BRICS
L’expression « zone d’IA open source des BRICS », largement reprise après le sommet, donne néanmoins un peu d’avance à l’histoire. Xi Jinping a proposé l’initiative ; les BRICS ne l’ont pas encore transformée en programme commun doté d’un budget, d’une infrastructure ou d’engagements nationaux précis.
La déclaration de New Delhi consacre bien une place importante à l’intelligence artificielle. Les onze membres appellent à renforcer l’accès aux technologies, les capacités des pays en développement, la coopération scientifique et une gouvernance internationale plus inclusive. La création d’une « AI Open Source Zone » n’y figure pourtant pas sous la forme annoncée par le dirigeant chinois.
Le texte officiel de son intervention est en revanche beaucoup plus précis. Xi propose que la Chine devienne « pionnière » dans la création d’une communauté BRICS d’IA open source, soutienne le développement et l’utilisation de grands modèles de langage, organise des formations spécialisées et participe à la constitution d’un « écosystème ouvert ». Dans la même intervention, il avance une troisième initiative moins commentée : la création d’une plateforme cloud pour l’écosystème numérique des BRICS, accompagnée de formations et d’échanges technologiques.
Cette juxtaposition change sensiblement la lecture. Le modèle ouvert n’arrive pas seul. À côté apparaissent l’infrastructure qui l’exécute, les compétences nécessaires à son utilisation et une coopération institutionnelle chargée d’organiser l’ensemble.
Pékin ne propose donc pas seulement du code. Il commence à proposer un environnement.
Quand l’ouverture devient une stratégie de distribution
La stratégie aurait eu une portée limitée si les modèles chinois restaient très en retrait par rapport à leurs concurrents américains. La situation a profondément changé.
Selon le Stanford AI Index 2026, l’écart entre le meilleur modèle américain et le meilleur modèle chinois n’atteignait plus que 2,7 % en mars sur son indicateur agrégé. Des modèles des deux pays ont même alterné plusieurs fois aux premières places depuis début 2025. Stanford souligne parallèlement les limites croissantes des benchmarks eux-mêmes, mais la tendance reste significative : l’avance technologique américaine mesurée sur les performances s’est fortement réduite.
L’autre donnée intéressante concerne moins la performance que la diffusion. Hugging Face recensait cet été plus de 2,04 milliards de téléchargements pour la famille Qwen sur les dépôts déclarant leur nombre de paramètres. À titre de comparaison, Moonshot, pourtant positionné sur des modèles beaucoup plus lourds, totalisait 37 millions de téléchargements. Hugging Face constate surtout que les laboratoires chinois occupent désormais une place exceptionnelle dans les modèles ouverts de grande taille.
Le phénomène ne se limite pas au téléchargement de poids. Sur OpenRouter, plateforme utilisée par des développeurs et des entreprises pour accéder à différents modèles depuis une même interface, DeepSeek représentait mi-juillet 16,7 % des tokens consommés, devant tous les autres éditeurs. Sa part avait quasiment doublé depuis le début de l’année. Deux modèles DeepSeek figuraient alors parmi les dix plus utilisés de la plateforme.
Ni Hugging Face ni OpenRouter ne constituent évidemment un recensement du marché mondial de l’intelligence artificielle. Le premier mesure une activité de téléchargement, le second son propre trafic. Leur intérêt se situe ailleurs : ils montrent que les modèles chinois ne sont plus seulement compétitifs dans les classements. Ils circulent, sont repris, hébergés par des tiers et intégrés dans des produits qui n’appartiennent pas nécessairement à leurs créateurs.
Cette diffusion représente un avantage stratégique difficile à mesurer dans un benchmark. Lorsqu’une entreprise construit un outil sur Qwen, qu’un développeur optimise DeepSeek ou qu’une université forme ses étudiants sur ces architectures, chacun produit de la documentation, des compétences, des modèles dérivés et des habitudes techniques. Une technologie commence alors à acquérir une valeur qui ne dépend plus exclusivement de son créateur.
Dans l’histoire du logiciel, les plateformes les plus durables n’ont pas toujours été celles qui possédaient à chaque instant le meilleur produit. Elles ont souvent été celles autour desquelles il devenait progressivement plus simple de construire que de partir ailleurs.
« Open source », le mot qui arrange aussi Pékin
Reste un problème de vocabulaire. La Chine parle volontiers d’« open source » alors qu’une partie des modèles présentés sous cette bannière correspond plus précisément à de l’open weight.
La nuance paraît technique, elle est pourtant centrale. La définition publiée par l’Open Source Initiative ne se contente pas d’exiger l’accès aux poids d’un modèle. Elle demande également que soient disponibles le code utilisé pour l’entraîner et le faire fonctionner ainsi que des informations suffisamment détaillées sur les données pour étudier, modifier et reconstruire un système équivalent.
Or publier les poids d’un modèle ne signifie pas nécessairement documenter intégralement son corpus d’entraînement, ses processus de filtrage ou toutes les étapes ayant conduit à sa fabrication. L’utilisateur dispose d’une liberté considérable pour exécuter et modifier le modèle sans disposer de la transparence nécessaire pour reproduire entièrement sa construction.
La différence importe d’autant plus que l’« ouverture » possède désormais une fonction politique. Elle installe une opposition séduisante entre, d’un côté, des services américains accessibles principalement par API et contrôlés par quelques entreprises, et de l’autre, des modèles que gouvernements, universités ou entreprises peuvent télécharger, adapter à leurs langues, installer dans leurs infrastructures et modifier.
Le récit fonctionne particulièrement bien dans les pays qui découvrent que l’adoption massive de l’intelligence artificielle risque de recréer certaines dépendances déjà observées avec le cloud, les systèmes d’exploitation ou les plateformes numériques.
Mais un modèle téléchargeable n’est pas pour autant un bien commun dégagé de toute stratégie industrielle. Son ouverture peut aussi devenir une manière particulièrement efficace de conquérir un marché.
Le cloud montre où se reconstruit la dépendance
Huawei donne une idée assez précise de cette seconde étape. Depuis avril, Huawei Cloud a étendu son offre Model-as-a-Service à neuf nouveaux pays : Singapour, Thaïlande, Indonésie, Brésil, Mexique, Arabie saoudite, Émirats arabes unis, Afrique du Sud et Turquie. La plateforme propose notamment DeepSeek, Qwen et GLM. Plusieurs de ces marchés appartiennent aux BRICS ou occupent une position centrale dans la compétition technologique entre Washington et Pékin.
L’exemple résume presque parfaitement le paradoxe de l’IA ouverte. Le modèle peut être librement récupérable tandis que l’infrastructure qui l’exécute demeure parfaitement commerciale. Une entreprise brésilienne peut réduire sa dépendance envers une API américaine en choisissant Qwen ou DeepSeek tout en transférant une partie de cette dépendance vers Huawei Cloud, ses outils d’optimisation et, demain, éventuellement des accélérateurs chinois.
La souveraineté ne disparaît donc pas comme problème ; elle change de couche.
Cette observation vaut d’ailleurs pour l’ensemble du marché. Une organisation qui exécute un modèle ouvert sur AWS ou Microsoft Azure reste dépendante d’un hyperscaler américain. Une autre qui choisit une infrastructure chinoise se retrouve dans une situation symétrique. Entre le modèle, les puces, le cloud, les logiciels d’orchestration et les compétences humaines, l’intelligence artificielle forme une chaîne dont chaque maillon constitue un point potentiel de dépendance.
Pékin semble avoir parfaitement identifié cette mécanique. La proposition faite aux BRICS associe désormais explicitement communauté open source et cloud commun. La question pertinente n’est alors plus seulement de savoir si la Chine ouvre ses modèles, mais jusqu’où elle parviendra à installer autour d’eux ses propres infrastructures.
Les États-Unis jouent exactement la même partie
Une lecture trop confortable consisterait à opposer la Chine de l’open source à une Amérique exclusivement propriétaire. Elle serait fausse.
Washington a lui aussi identifié la diffusion technologique comme un enjeu géopolitique. L’AI Action Plan présenté par l’administration Trump en 2025 affirme explicitement que les États-Unis doivent favoriser l’adoption mondiale de leurs systèmes, de leur matériel informatique et de leurs standards. Le document évoque même le risque que des pays insuffisamment servis par l’industrie américaine se tournent vers ses rivaux.
Cette doctrine possède désormais son outil opérationnel. L’American AI Exports Program organise des consortiums industriels capables de proposer à des acheteurs étrangers des solutions couvrant toute la chaîne : puces, serveurs, data centers, réseaux, traitement des données, modèles, cybersécurité et applications. Les projets retenus bénéficient d’un soutien fédéral pour les licences d’exportation, le financement et la diplomatie commerciale.
Le décret présidentiel qui fonde ce programme a le mérite de la clarté : il s’agit de favoriser l’adoption mondiale des technologies, standards et modèles de gouvernance américains et de diminuer la dépendance internationale envers les technologies des adversaires des États-Unis.
L’affrontement devient plus intéressant lorsqu’on le regarde ainsi. Washington dispose d’un avantage considérable sur les semi-conducteurs avancés, les hyperscalers et plusieurs modèles propriétaires parmi les plus performants. Il cherche à exporter cet avantage sous la forme d’un « full stack » cohérent. Pékin, davantage contraint sur certaines puces de pointe, possède désormais des modèles compétitifs qu’il diffuse largement et autour desquels il développe cloud, formation, services et coopération institutionnelle.
Les deux puissances emploient des instruments différents pour poursuivre un objectif assez proche : faire en sorte que le développement de l’IA ailleurs dans le monde repose autant que possible sur leurs technologies.
Le Sud global devient un terrain de distribution
La création en juillet de la World Artificial Intelligence Cooperation Organization, signée par 29 pays, ajoute une pièce institutionnelle au dispositif chinois. Présentée comme une structure de coopération internationale et de gouvernance de l’IA, elle donne à Pékin un cadre supplémentaire pour défendre ses conceptions auprès d’États qui ne souhaitent pas nécessairement laisser Washington et les grandes entreprises américaines définir seuls les règles du secteur.
Le choix des BRICS comme nouveau véhicule n’a donc rien d’anodin. Leur intérêt pour la Chine réside moins dans l’existence d’un hypothétique bloc technologique homogène que dans leur capacité à réunir des économies suffisamment importantes pour donner de l’échelle à une infrastructure alternative.
Parler d’un « Sud global » prêt à adopter l’écosystème chinois serait toutefois une simplification. L’Inde cherche elle-même à construire une industrie de l’IA souveraine. Les Émirats arabes unis et l’Arabie saoudite investissent massivement dans des partenariats américains tout en conservant des relations technologiques avec Pékin. Le Brésil défend régulièrement une autonomie numérique qui ne signifie pas nécessairement un alignement chinois.
Cette diversité représente peut-être le principal obstacle à la stratégie de Xi Jinping. Les mêmes pays qui souhaitent échapper à une dépendance excessive envers les plateformes américaines n’ont aucune raison évidente d’en créer une nouvelle envers la Chine.
La future communauté BRICS constituera à ce titre un test beaucoup plus intéressant que son annonce. Si plusieurs pays développent réellement leurs propres briques, contribuent aux modèles, partagent des capacités de calcul et définissent collectivement les règles, un nouvel espace technologique aura commencé à émerger. Si les infrastructures, modèles et outils demeurent principalement chinois, l’initiative ressemblera davantage à une politique d’exportation placée sous une bannière multilatérale.
La différence entre coopération et influence se mesurera là.
La prochaine guerre de l’IA sera une guerre des dépendances
La proposition de Xi Jinping mérite finalement d’être regardée moins comme une annonce sur l’open source que comme un indice de l’endroit où se déplace la compétition mondiale.
La Chine n’a pas besoin que Qwen ou DeepSeek dominent chaque benchmark. Elle a besoin que suffisamment de développeurs construisent avec eux, que suffisamment d’entreprises les intègrent et que suffisamment de gouvernements les considèrent comme une infrastructure crédible. À partir d’un certain niveau d’adoption, documentation, compétences, outils et investissements produisent leurs propres effets de réseau.
Les États-Unis poursuivent le même raisonnement lorsqu’ils organisent l’exportation de leur stack technologique complet. Derrière l’affrontement très visible entre OpenAI, Google, Anthropic, DeepSeek ou Alibaba se joue ainsi une compétition beaucoup plus lente, dont les résultats apparaîtront dans les choix techniques ordinaires d’une banque indonésienne, d’un ministère brésilien, d’une université africaine ou d’une entreprise industrielle du Golfe.
Quel modèle utiliser ? Sur quel cloud l’exécuter ? Avec quelles puces ? Quels outils maîtriser ? Selon quelles normes organiser les données et la sécurité ?
Aucune de ces décisions ne déterminera seule le futur de l’intelligence artificielle. Leur accumulation, pendant cinq ou dix ans, dessinera pourtant l’architecture numérique sur laquelle fonctionneront des pans entiers des économies nationales.
Voilà pourquoi l’initiative chinoise mérite davantage d’attention qu’un nouvel épisode de la compétition entre DeepSeek et OpenAI. Pékin essaie de transformer l’ouverture de ses modèles en avantage de distribution, cet avantage de distribution en écosystème, puis cet écosystème en influence.
Pendant trois ans, la question dominante de l’IA a été de savoir qui construirait le modèle le plus intelligent. Une autre devient progressivement plus importante : qui réussira à construire l’infrastructure dont les autres auront le plus de mal à se passer ?
Augustin GARCIA