Navier-Stokes : 88 heures de recherche, mais 90 ans de science derrière elles
Le 8 septembre 2026, OpenAI a annoncé un résultat suffisamment spectaculaire pour déclencher immédiatement deux réactions opposées : l’enthousiasme devant la performance et la méfiance devant un récit ressemblant presque trop parfaitement à une démonstration de puissance de l’intelligence artificielle.
L’entreprise affirme qu’un modèle interne, présenté comme sensiblement plus performant que GPT-6 Astra, a produit une démonstration concernant le problème d’existence et de régularité de Navier-Stokes, l’un des sept problèmes du Millénaire définis en 2000 par le Clay Mathematics Institute.
La campagne aurait mobilisé de l’ordre de 10 000 agents simultanés. Après environ 88 heures, le système aurait construit une démonstration analytique selon laquelle un fluide initialement au repos peut développer en temps fini une singularité sous l’action d’une force extérieure régulière, tout en conservant une énergie finie. OpenAI affirme ainsi satisfaire les formulations C et D du problème officiel. La démonstration a ensuite fait l’objet d’une formalisation et d’une vérification dans Lean pendant 17 heures supplémentaires avec GPT-6 Astra.
L’échelle du calcul impressionne presque autant que le résultat revendiqué : 2,7 millions de messages entre agents et environ 130 milliards de tokens de sortie pour Navier-Stokes. Tous problèmes confondus, la campagne lancée par OpenAI représente 4,9 millions de messages et environ 300 milliards de tokens.
Cela ne transforme pas pour autant Navier-Stokes en problème définitivement « résolu ». Le Clay Mathematics Institute le classe toujours parmi les problèmes ouverts. Avant l’examen d’une proposition pour le prix d’un million de dollars, les règles exigent notamment une publication dans un support admissible, deux années écoulées depuis celle-ci et une acceptation générale par la communauté mathématique. OpenAI indique de son côté ne pas vouloir réclamer le prix.
La formalisation dans Lean renforce la solidité de la chaîne logique encodée, mais elle ne remplace pas entièrement l’examen scientifique. Il reste à vérifier que l’énoncé formalisé correspond précisément au problème revendiqué, à comprendre les idées de la preuve et à éprouver les hypothèses utilisées. Une preuve mathématique ne devient pas seulement importante parce qu’une machine accepte chacune de ses étapes : elle le devient aussi lorsque des mathématiciens savent expliquer pourquoi elle fonctionne et comment elle s’insère dans le reste du savoir.
La comparaison entre 88 heures de calcul et près de 90 années de recherches humaines est donc trompeuse. Les agents n’ont pas travaillé face à neuf décennies de mathématiques. Ils ont travaillé à partir d’elles.
10 000 agents ne sont pas 10 000 mathématiciens
L’aspect le plus intéressant de l’annonce se trouve peut-être moins dans la démonstration elle-même que dans la manière dont OpenAI dit l’avoir obtenue.
Les agents disposaient d’outils de programmation et d’un accès à une version mise en cache du Web. Ils étaient répartis en groupes recevant différentes variantes des problèmes étudiés. Certaines équipes ont exploré des voies susceptibles d’établir la régularité de Navier-Stokes, d’autres celles susceptibles de produire un contre-exemple. Des résultats intermédiaires ont ensuite circulé entre groupes, Codex servant à consolider les pistes jugées les plus intéressantes avant de les réinjecter dans de nouvelles explorations.
Un résultat obtenu auparavant par une centaine d’agents sur les équations d’Euler a conduit OpenAI à déplacer davantage de ressources vers Navier-Stokes. Même le modèle sous-jacent a été remplacé en cours de campagne lorsqu’une version plus avancée est devenue disponible.
Nous sommes loin de l’image d’un chatbot auquel un chercheur pose une question particulièrement difficile. L’organisation ressemble davantage à une immense campagne de recherche computationnelle : multiplier les voies, éliminer celles qui échouent, faire circuler certains résultats et concentrer progressivement les ressources sur les approches prometteuses.
Il serait pourtant abusif de parler de 10 000 chercheurs artificiels. Des milliers d’instances d’un même système ne constituent pas des milliers d’intelligences réellement indépendantes. Elles partagent des modèles, des données et probablement une partie de leurs biais. Dix mille agents reproduisant la même erreur ne fournissent pas dix mille confirmations. Le nombre d’agents ne mesure pas non plus la productivité scientifique.
OpenAI donne le temps écoulé et la quantité de tokens produits, mais ne publie pas le coût financier ou énergétique complet de l’expérience. Rien ne montre encore que 10 000 agents constituent la meilleure organisation possible, ni ce qu’auraient obtenu 1 000 agents pendant davantage de temps ou une architecture différente consommant la même puissance de calcul.
Trois grandeurs doivent donc rester séparées : la vitesse, le volume de calcul et l’efficacité. Obtenir un résultat en quatre jours représente une accélération spectaculaire du calendrier. Cela ne démontre pas encore une baisse du coût réel de la découverte.
Les premiers traits d’une industrialisation de l’exploration
Le mot « industrialisation » doit rester prudent, mais il devient difficile à éviter. L’industrie ne se caractérise pas simplement par l’utilisation de machines. Elle organise la répétition, la division des tâches, la mesure des résultats et l’allocation des ressources afin de produire davantage avec une organisation reproductible.
Le système décrit par OpenAI en présente certains traits appliqués à l’exploration intellectuelle. Des milliers de tentatives sont effectuées en parallèle. Les échecs deviennent acceptables parce que leur coût individuel diminue. Les résultats intermédiaires circulent. Les ressources suivent les pistes jugées prometteuses.
Une équipe humaine fonctionne nécessairement autrement. Même composée de chercheurs exceptionnels, elle doit choisir très tôt les hypothèses qu’elle consacrera plusieurs semaines ou plusieurs mois à explorer. Une mauvaise intuition coûte du temps humain. Une architecture multi-agents peut transformer cet arbitrage en problème de capacité de calcul.
Navier-Stokes n’établit pas encore que cette approche soit généralisable ou économiquement optimale. Il en montre cependant une forme possible : une recherche dans laquelle l’abondance de tentatives compense partiellement l’incertitude sur la bonne direction à prendre.
Une évolution semblable apparaît ailleurs dans les sciences, sans avoir attendu les grands modèles génératifs. Simulation numérique, chimie computationnelle, criblage virtuel ou calcul scientifique à haute performance explorent depuis longtemps des espaces immenses. L’IA ajoute cependant une dimension : certains modèles ne se contentent plus d’évaluer des candidats existants. Ils en génèrent directement de nouveaux.
Des milliers de candidats, quelques expériences
Dans les matériaux, MatterGen illustre cette évolution. Présenté dans Nature en 2025, le système génère des structures cristallines répondant à différentes contraintes de composition ou de propriétés physiques. Les auteurs ont notamment synthétisé expérimentalement un matériau proposé par le modèle et mesuré une propriété située à moins de 20 % de la valeur recherchée. Ils insistent eux-mêmes sur la limite de l’exercice : la validation expérimentale demeure le test ultime. La biologie offre un exemple encore plus parlant.
En août 2026, des chercheurs de Stanford ont décrit l’utilisation d’Evo 2 pour générer de nouveaux génomes de bactériophages, des virus capables d’infecter des bactéries. À partir de milliers de propositions, les scientifiques ont synthétisé et testé près de 300 phages contre E. coli. Seize ont finalement été retenus pour leurs performances. Quelques candidats ont obtenu en laboratoire une fitness supérieure à celle du phage naturel utilisé comme référence.
La succession des opérations importe davantage que le nombre final : génération, évaluation informatique, sélection, synthèse physique, test expérimental. Le modèle produit des possibilités. Le laboratoire produit la connaissance.
Cette distinction pourrait devenir l’un des principaux enjeux de la science assistée par IA. Lorsque générer un candidat exigeait beaucoup de travail, trouver une bonne hypothèse constituait une part majeure du problème. Si un système en propose demain dix mille, cent mille ou un million, la difficulté se déplace.
Quels matériaux synthétiser ? Quelles molécules tester ? Quelles séquences biologiques présentent suffisamment d’intérêt pour justifier leur fabrication ? Quelles démonstrations méritent plusieurs semaines de vérification humaine ?
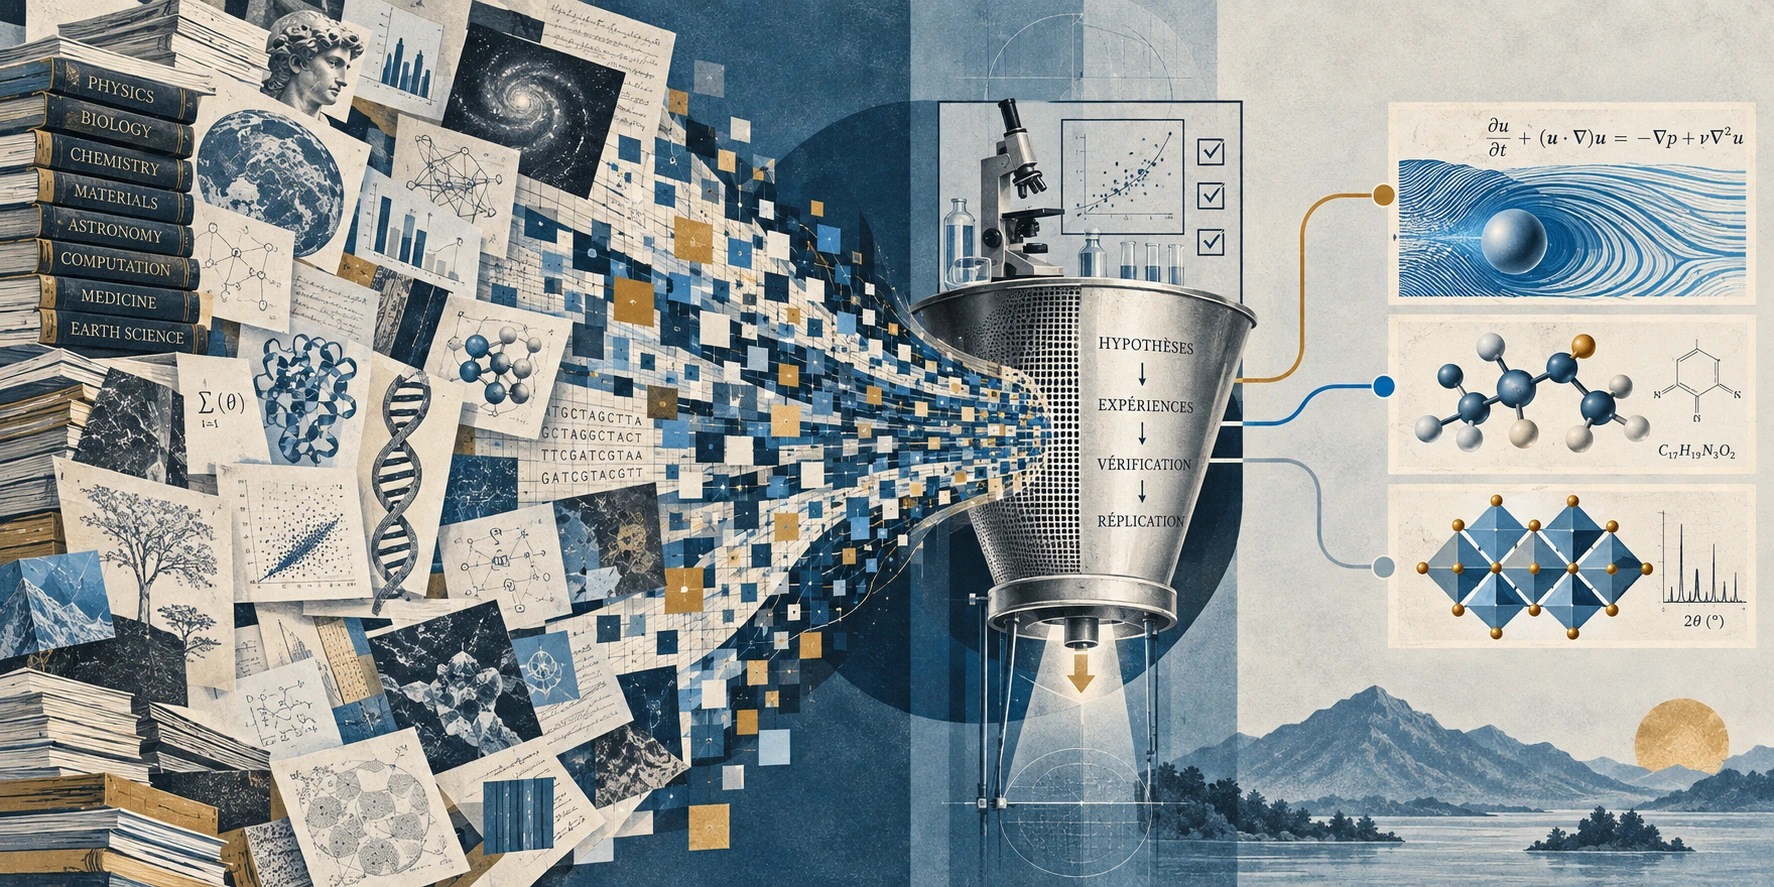
Les hypothèses deviennent abondantes alors que les capacités expérimentales restent rares. L’image d’une « fabrique à hypothèses » décrit assez bien cette nouvelle économie : une quantité considérable de propositions entre dans le système, mais seules quelques-unes franchissent le filtre de l’expérience, de la reproduction et de la validation.
Produire une idée ne suffit pas à faire une découverte
Cette abondance complique également une notion déjà délicate : l’auteur d’une découverte. Prenons une molécule proposée par un modèle. Un scientifique a défini le problème. D’autres ont créé les données sur lesquelles le système a appris. Des ingénieurs ont conçu le modèle. Une entreprise ou un laboratoire finance le calcul. Un algorithme génère dix mille structures. Des chercheurs en sélectionnent vingt. Une équipe en synthétise cinq et une seule produit finalement l’effet recherché.
Attribuer toute la découverte à la machine serait aussi simplificateur que nier sa contribution. L’épisode Navier-Stokes montre déjà la difficulté. OpenAI explique avoir lancé sa campagne après avoir entendu parler d’avancées réalisées par Tristan Buckmaster, professeur à NYU, et Levent Alpöge, chercheur chez Anthropic, sur des problèmes voisins liés aux équations d’Euler. Les deux chercheurs utilisaient eux-mêmes différents systèmes d’IA dans leur travail.
La proximité temporelle a suscité des interrogations sur un éventuel usage de données issues de leurs interactions avec les produits d’OpenAI. Après investigation, l’entreprise a mis à jour sa communication le 10 septembre et affirme désormais que les prompts Codex de Buckmaster au cours des deux mois précédents n’ont pas pu influencer le système utilisé, y compris par l’entraînement. OpenAI reconnaît parallèlement la priorité des travaux de Buckmaster et Alpöge sur le cas d’Euler avec force extérieure.
L’intérêt dépasse cette controverse particulière. À mesure que les chercheurs intégreront les assistants IA à leur travail, les idées circuleront dans des chaînes de plus en plus complexes : articles scientifiques, conversations avec des modèles, résultats intermédiaires, agents spécialisés, bases de données et outils formels.
La traçabilité deviendra alors une composante de l’infrastructure scientifique. Version du modèle, sources utilisées, étapes intermédiaires, interventions humaines et parcours de validation compteront davantage pour comprendre comment une idée est devenue un résultat.
Car une proposition générée n’est pas encore une découverte. Celle-ci se construit aussi par la compréhension, la vérification, la reproduction et l’acceptation collective.
Le nouveau goulot d’étranglement : modèle, compute, laboratoire
Cette transformation introduit enfin une question beaucoup moins abstraite : qui disposera des infrastructures nécessaires pour organiser cette recherche ?
L’accès se joue désormais sur au moins trois étages.
Le premier concerne le modèle. Certains restent fermés, d’autres circulent plus largement. Stanford a par exemple rendu Evo 2 disponible ouvertement et gratuitement.
Le deuxième concerne le calcul. Disposer du modèle ne signifie pas disposer des milliers d’accélérateurs, du stockage et de l’infrastructure nécessaires pour lancer des campagnes massives.
Le troisième concerne le monde physique : laboratoires, instruments, spécialistes, essais cliniques, synthèse chimique ou caractérisation des matériaux. Aucune quantité de tokens ne remplace cette étape.
Cette distinction relativise l’idée d’une science soudainement démocratisée par des modèles accessibles. Le Stanford AI Index 2026 estime que l’industrie a produit plus de 90 % des modèles de frontière notables en 2025, alors que l’activité scientifique et les publications restent beaucoup plus réparties entre monde académique, entreprises et États. Les outils les plus puissants et les communautés qui produisent les connaissances ne se confondent donc plus nécessairement.
L’Europe tente de répondre à cette concentration par l’infrastructure. EuroHPC supervise désormais 19 AI Factories. Son dispositif prévoit un accès spécifique à la recherche scientifique et des allocations industrielles allant jusqu’à plus de 50 000 heures GPU pour les projets de grande ampleur. Des AI Gigafactories doivent encore augmenter cette capacité.
La question rappelle celle des grands instruments scientifiques. Tous les chercheurs peuvent étudier les particules ou l’astronomie ; très peu d’institutions peuvent construire un accélérateur ou un télescope géant. Une partie de la recherche en IA pourrait suivre un chemin comparable.
Quand l’hypothèse devient abondante, le choix devient stratégique
Le chercheur humain ne disparaît pas de cette nouvelle organisation. Sa fonction se concentre au contraire sur les endroits où la rareté persiste : poser une bonne question, concevoir une expérience, identifier les critères de sélection, comprendre un résultat, détecter une erreur et assumer la responsabilité de la conclusion.
La nouvelle variable est la quantité d’exploration dont il dispose avant de devoir choisir. Une organisation capable de financer dix mille agents peut tester davantage de voies, supporter davantage d’échecs et poursuivre des idées qu’une équipe plus contrainte aurait abandonnées. Cela ne garantit ni la qualité des questions ni la valeur des découvertes. Une mauvaise hypothèse explorée dix mille fois reste une mauvaise hypothèse. Mais la capacité d’exploration devient malgré tout une forme de pouvoir.
Une entreprise peut concentrer cette puissance sur une molécule susceptible de générer un marché considérable. Un État peut privilégier une technologie énergétique ou militaire. Une institution publique peut décider de financer une maladie rare ou une question fondamentale dont le retour économique est incertain.
À mesure que l’IA rendra les hypothèses plus abondantes, le choix des hypothèses auxquelles consacrer du calcul, du temps humain et des expériences deviendra plus déterminant. Voilà sans doute le véritable enseignement des 10 000 agents d’OpenAI. Le chiffre raconte moins le remplacement de 10 000 chercheurs que l’apparition d’une nouvelle capacité industrielle d’exploration. Navier-Stokes servira peut-être de démonstration historique de cette méthode, ou seulement de première expérience spectaculaire. Son importance dépendra aussi de ce que la communauté mathématique conclura de la preuve.
Mais le problème posé à la science dépasse déjà cette démonstration. Lorsque des machines savent produire des milliers de pistes, la question décisive n’est plus seulement de savoir qui saura découvrir. Elle devient de savoir qui disposera des moyens de choisir ce qui mérite d’être découvert.
Antoine GARCIA